El código abierto pasó de un susurro a un coro en nuestras páginas
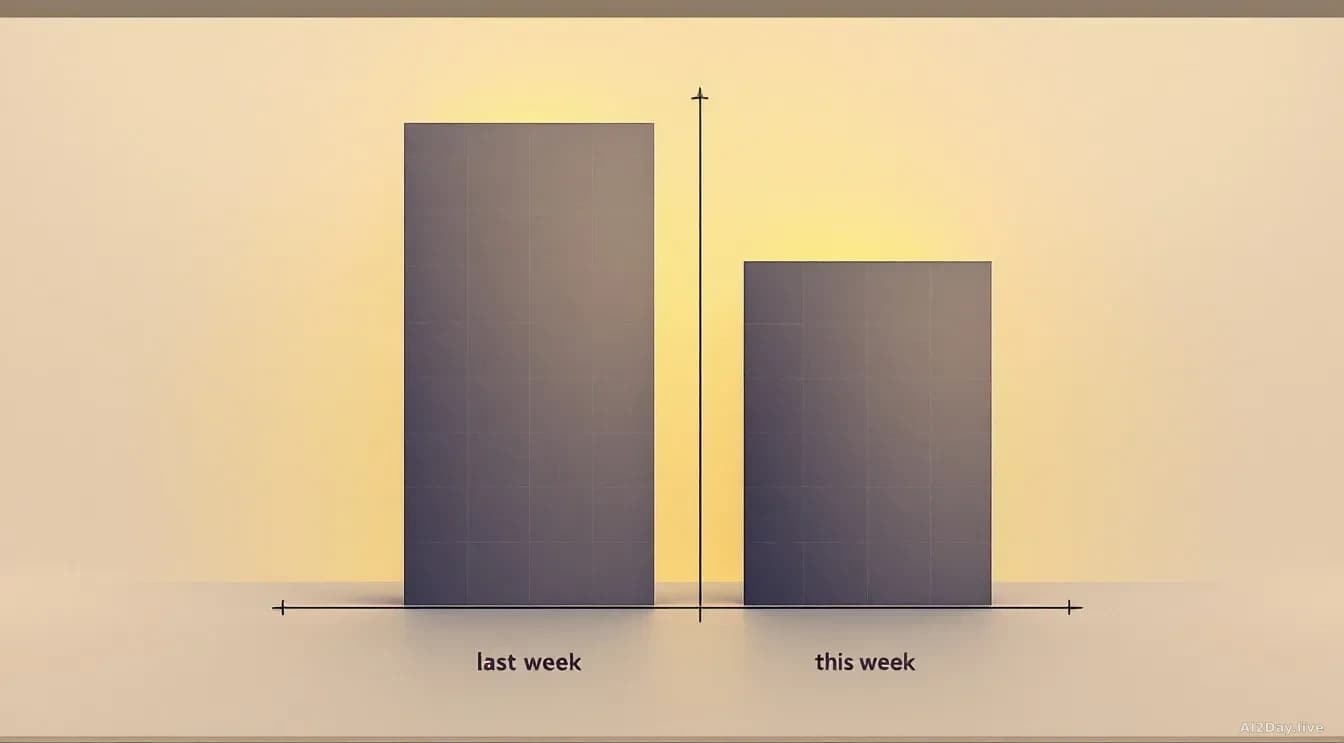
AI2Day publicó cinco historias sobre IA de código abierto en la semana del 29 de septiembre al 6 de octubre de 2026, comparado con una la semana anterior. Tres medios diferentes cubrieron la noticia, así que no se trata de una sola redacción obsesionada con el tema.
Puntos clave
- AI2Day publicó 5 historias sobre IA de código abierto entre el 30 de septiembre y el 6 de octubre de 2026, frente a 1 la semana anterior, un aumento del 400%.
- Esas 5 historias representaron el 12,8% de las 39 piezas que publicamos esa semana; la producción total fue plana respecto a las 39 de la semana anterior.
- La cobertura provino de 3 medios separados, no de una única fuente promocionando una narrativa.
- Los lanzamientos que cubrimos abarcaban desde un modelo de búsqueda multimodal del tamaño de un teléfono hasta un sistema de entrenamiento dirigido a IA de parámetros de billones.
Durante la mayor parte de las dos últimas semanas, la IA de código abierto apenas registró presencia en lo que publicamos. Una historia. Luego cinco.
La forma del salto importa más que el número absoluto. Cinco historias de 39 sigue siendo un acompañamiento, no el plato principal. Pero esas cinco procedían de tres medios diferentes, lo que significa que al menos tres editores decidieron independientemente que un lanzamiento de código abierto valía la pena para un lector en los mismos siete días.
¿Qué llegó realmente?
Cuatro lanzamientos concretos y una pieza sobre sentimiento de lectores. Los lanzamientos no eran variaciones de un mismo tema. Estaban situados en diferentes capas del stack, lo que hace que el conglomerado sea interesante en lugar de coincidencia.
Google lanzó un modelo pequeño que funciona en un teléfono y busca texto, imágenes, audio y video, cubierto en Google's new EmbeddingGemma 2 crams search for text, images, audio and video onto a phone. Un modelo de embedding, en términos sencillos, es el software que convierte una foto o una frase en una serie de números que un ordenador puede comparar con otras series de números. Poner eso en un dispositivo móvil significa que la búsqueda nunca tiene que abandonar el dispositivo.
En el otro extremo de la escala, el Instituto Allen lanzó la infraestructura para entrenar modelos enormes, en The Allen Institute Just Open-Sourced a Training System for Trillion-Parameter AI Models. Los modelos de parámetros de billones son los sistemas de IA muy grandes que normalmente solo un puñado de laboratorios bien financiados pueden permitirse construir. Abrir el código de entrenamiento no entrega a nadie el modelo terminado, pero reduce la barrera para quienes quieren intentarlo.
Entre medias, un pequeño modelo abierto que redacta un informe de investigación en 51 segundos en una máquina doméstica, y un nuevo ranking de Hugging Face que clasifica IA de voz de código abierto en horas en lugar de semanas. Estos están en A Tiny Open-Source AI Can Write a Research Report in 51 Seconds y Hugging Face Can Now Rank Every Open-Source Voice AI in Hours.
¿Es esta una tendencia real o una coincidencia?
Honestamente, no podemos saberlo aún después de una semana. Un aumento del 400% suena dramático, y lo es, pero la base era una historia. Pasar de una a cinco es el tipo de movimiento que puede revertirse la semana siguiente sin que nadie lo note.
Lo que va en contra del puro ruido: las historias son estructuralmente diferentes. Un embedder del tamaño de un teléfono, un entrenador de escala de billones, un escritor de informes de escritorio, un ranking de modelos de voz. Si esto fuera un lanzamiento de producto reverberando por toda la web, esperaríamos cuatro reseñas de lo mismo. Obtuvimos cuatro reseñas de cuatro cosas diferentes.
¿Qué lo confirmaría y qué lo desmentería?
Confirmarlo: otra semana con cinco o más historias de código abierto, de una distribución similar de medios, con al menos un lanzamiento más en una nueva capa del stack (datos de entrenamiento, herramientas de ajuste fino, evaluación).
Desmentirlo: la próxima semana cae de nuevo a una o cero, y las cinco que vimos resultan haber estado agrupadas alrededor de una sola conferencia o ventana de anuncio de una sola fundación.
Mi lectura, por lo que vale una medición de una semana: el hecho de que una pieza sobre sentimiento de lectores, A Billion Users, and Most of Them Are Nervous About It, llegara la misma semana que cuatro lanzamientos abiertos es el detalle que estaré observando. Usuarios nerviosos y modelos inspeccionables abiertamente son argumentos relacionados. Si los editores siguen emparejándolos, el conglomerado es una historia. Si no, fue un martes ocupado.